CRONOS
O que é
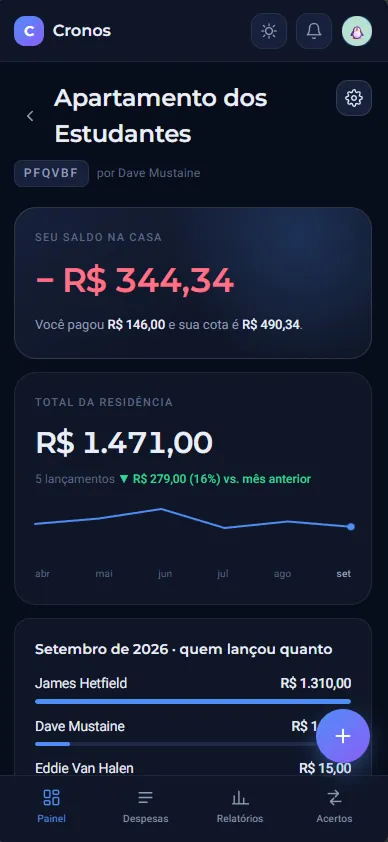
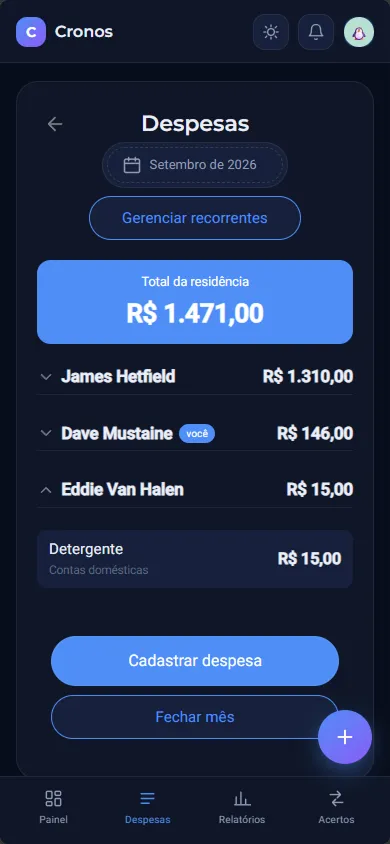
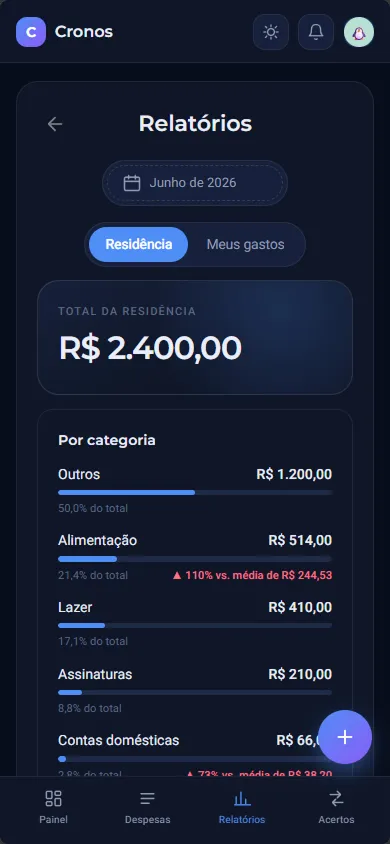
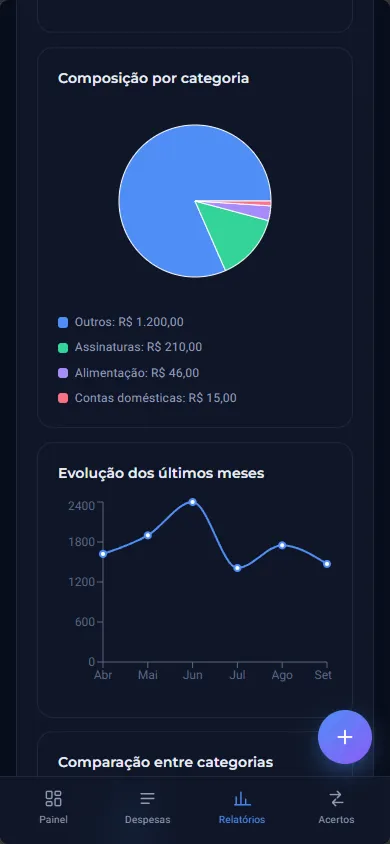
O CRONOS é uma plataforma de controle de despesas compartilhadas. Ela permite registrar as despesas de um grupo de pessoas e ratear a conta no final do mês. Escrevi a aplicação inteira, front-end, API e banco, e também sou responsável pela infraestrutura que a mantém no ar.
Contexto
Esse é o terceiro sistema que escrevo para o mesmo problema. Comecei com um sistema financeiro de mesa em Java com Swing, para controlar despesas compartilhadas. O CRONOS é a mesma ideia levada para a web e depois para a nuvem. A pergunta é sempre a mesma, “quem deve pra quem”, e ela já atravessou três arquiteturas diferentes.
Na nuvem, o orçamento é apertado: uma instância pequena, memória limitada, sem verba para escalar horizontalmente. Qualquer decisão de infraestrutura precisava caber nesse espaço.
O problema
Rodar uma aplicação Next.js, uma API Node.js e um PostgreSQL com pouca RAM, sem que o banco ou o processo Node estourem memória em produção. E fazer isso com CI/CD, publicando imagem a cada push, em vez de deploy manual.
Como resolvi
Escolhi ECS sobre EC2 em vez de Fargate, migrei a instância para ARM64 (t4g.small), coloquei uma
borda em Caddy na frente da aplicação e configurei o GitHub Actions para rodar a suíte de testes e
publicar a imagem no GHCR a cada push. O build do front-end usa o modo standalone do Next.js, que
reduz bastante o que efetivamente sobe para o registry.
Como eu sei que funciona
O sistema mexe com dinheiro entre pessoas que moram juntas. Um rateio errado significa alguém pagando a conta do outro. Por isso a suíte de testes cobre as três camadas da pirâmide, e nada vai para produção sem passar por ela.
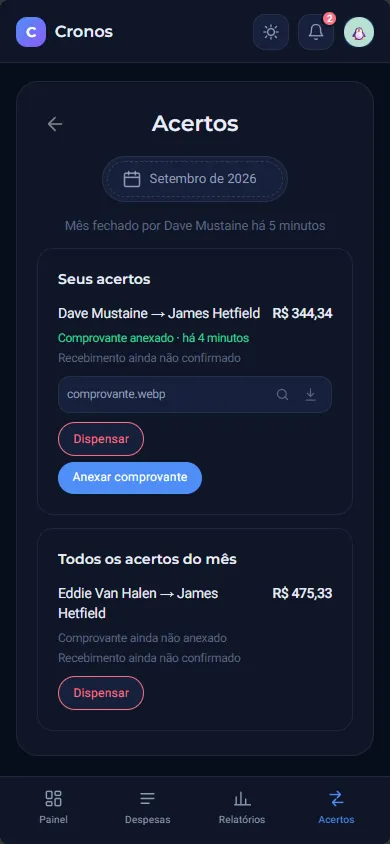
Na API, são 34 arquivos de teste em Jest. Os 19 unitários cobrem os schemas Zod, as regras dos services e o rateio propriamente dito. Os 15 de integração usam Supertest contra a aplicação, com um PostgreSQL subido como serviço no runner. Eles exercitam auth, residências, despesas, notificações, usuários e acertos de pagamento, além dos casos de segurança: rate limiting, reúso de refresh token, troca e recuperação de senha e emissão dos eventos de segurança.
Email e armazenamento de comprovantes são portas injetáveis, trocadas por fakes em memória na suíte,
então nenhum teste automatizado abre conexão com a AWS. Os limitadores de taxa ficam desarmados em
NODE_ENV=test, porque a suíte dispara dezenas de requisições na mesma rota de propósito. Armados,
eu estaria testando o limitador em vez do endpoint. Existe um gancho para armá-los nos testes que são
especificamente sobre rate limiting.
No front-end, são 46 suítes e 294 testes em Jest com Testing Library, sobre Server Actions, hooks e
formulários. Antes de escrever teste novo, precisei consertar a métrica. O jest.config.ts não tinha
collectCoverageFrom, então a cobertura só contava arquivos já importados por algum teste e reportava
68%, um número que subia quanto menos código eu testasse. Com o denominador correto, a cobertura era
18,4%. Levei para 58,2% seguindo um plano versionado no repositório, que registra também o que ficou
de fora e por quê.
Os 16 specs de Cypress cobrem os fluxos que um usuário percorre: criar conta, criar e entrar em residência, lançar, editar e excluir despesa, despesa recorrente, fechar e reabrir o mês, convidar e gerenciar membros, acertos de pagamento, relatórios e recuperação de senha.
Como a entrega é fechada
A entrega segue o modelo build once, promote everywhere. Os repositórios do front-end e da API rodam
lint, testes e build, publicam a imagem no GHCR e disparam por repository_dispatch o repositório
orquestrador de deploy. Ele sobe a stack inteira com Docker Compose (Postgres, API e front-end), roda
o Cypress contra ela e, só se tudo passar, re-taggeia com imagetools aquele artefato exato como
:stable.
Nada é reconstruído para produção. A imagem que vai ao ar é a mesma que passou no E2E. Quando um spec falha, screenshots e vídeos sobem como artefato do job. Sem eles, a única informação seria “o teste não passou”, o que não distingue timeout, erro devolvido pela API e front sem conseguir falar com a API.
O que eu troquei pelo quê
Escolhi ECS sobre EC2 em vez de Fargate porque, no tamanho deste sistema, Fargate custava mais que a instância inteira. O preço disso é que eu administro a máquina. Swap, limite de memória do Postgres e o agente ECS são problema meu.
Na cobertura de testes, parei em 58,2% em vez de perseguir um número redondo. Composição de rota,
page.tsx e layout.tsx estão fora do denominador porque o comportamento deles já é exercitado pelo
Cypress. Testá-los duas vezes encareceria a suíte sem aumentar a confiança.
Resultado
A imagem do front-end caiu de mais de 1 GB para cerca de 390 MB (payload de 47 MB) depois do build
standalone. O custo da instância caiu de US$ 15,18 para aproximadamente US$ 6,13 por mês com a
migração para t4g. O Postgres roda hoje com teto de 384 MB de memória, o que faz de cada decisão de
configuração um exercício de restrição concreta.
Em qualidade, a cobertura de statements do front-end saiu de 18,4% para 58,2%, a API tem 34 arquivos
de teste entre unitários e integração com banco real, e 16 fluxos de ponta a ponta rodam contra a
stack completa antes de qualquer imagem virar :stable.
O que eu faria diferente
[VOCÊ ESCREVE]
Links
- Site: cronos.gabrielmizael.com
- Repositórios: front-end, API e deploy